Inleiding
Voordat we beschrijven hoe een betrouwbaar register werkt, leggen we vast waarom we dit doen, hoe we naar registers kijken en waarover dit ontwerp iets zegt. Het conceptueel registerontwerp bouwt daarop voort.
We spreken bewust van register en niet van registratie. Dat sluit aan bij gewoon taalgebruik – volgens Van Dale is registratie de "inschrijving in een register" – en voorkomt de indruk dat het ontwerp (alleen) gericht is op basisregistraties.
Waarom dit ontwerp?
De overheid is bevoegd vergaand in te grijpen in de situatie van burgers en bedrijven. Door automatisering doet ze dat op steeds grotere schaal. Ons vermogen om overheidshandelen te begrijpen, te controleren en gemaakte fouten te herstellen zijn niet evenredig meegegroeid.
Als het misgaat, worden daardoor niet alleen meer burgers en bedrijven geraakt. Omdat gegevens geautomatiseerd door ketens stromen en meerdere organisaties erop handelen, hebben fouten ook verstrekkender gevolgen.
Dit model beschrijft hoe registers overheidsinformatie zo kunnen vastleggen en beschikbaar stellen dat we de waarde ervan beter kunnen beoordelen, fouten zoveel mogelijk voorkomen en ze – als dat niet lukt – in ieder geval kunnen herstellen.
De happy en de crappy flow
Zolang burgers en bedrijven vragen wat we vooraf hadden bedacht, tijdig de juiste informatie aanleveren en 'onze' gegevens kloppen, verlopen processen snel en met beperkte menselijke tussenkomst. Dat is de happy flow, die in de meeste gevallen gevolgd kan worden.
Past een situatie daar echter niet bij, of moet iets worden aangevochten, onderzocht of gecorrigeerd, dan belanden we in de crappy flow: een werkstroom die vrijwel altijd handwerk vraagt en soms helemaal niet wordt afgehandeld.
Resultaten uit de happy flow verspreiden zich daardoor gemakkelijk en geautomatiseerd door het overheidsapparaat. Uit de crappy flows voortkomende betwijfelingen en correcties bereiken 'stroomafwaarts' gelegen domeinen daarentegen moeizaam of helemaal niet.
Hoe komt de crappy flow in het ontwerp terug? Terugmelden, twijfelen en corrigeren ondersteunen aanvechten, onderzoeken en herstellen, betekenisvol notificeren helpt betwijfelingen en correcties stroomafwaarts te brengen.
Epistemische nederigheid
Betere ondersteuning van de crappy flow lost echter niet alles op. Hoeveel crappy flows we ook in happy flows veranderen: onjuistheden in overheidsinformatie blijven bestaan. Wie overheidsregisters toch als onfeilbaar behandelt, schept dus een tweede probleem: overmatig vertrouwen. Daartegenover stellen we _epistemische nederigheid: erkennen dat onze kennis beperkt, voorlopig en mogelijk onjuist is.
Epistemisch nederig handelen is onmogelijk zonder gereedschap om de waarde van informatie te beoordelen. We kunnen nu vaak niet achterhalen wie een keten van overheidshandelen in beweging heeft gezet, wanneer en waarom, en we zien niet hoe lang óns handelen verderop in de keten doorwerkt.
Daarvoor moeten we van informatie kunnen nagaan waar die vandaan komt (herkomst), hoe die door de tijd is veranderd (tijd), hoe zeker we zijn over de juistheid ervan (zekerheid) en wat we ermee bedoelen (betekenis).
Hoe komt epistemische nederigheid in het ontwerp terug? De vier betrouwbaarheidsaspecten – herkomst, tijd, zekerheid en betekenis ondersteunen epistemische nederigheid, net als de onze keuze voor wat het register bevat: beweringen, geen feiten.
Hoe we naar registers kijken
Performatieve handelingen en afgeleide representaties
Overheidsinformatie ontstaat uit handelen. Vaak is dat handelen performatief, wat betekent dat door dat handelen een nieuwe (administratieve) situatie ontstaat. Verklaart de ambtenaar van de burgerlijke stand twee mensen bijvoorbeeld in de echt verbonden, dan zijn zij vanaf dat moment getrouwd, met de rechten en plichten die daarbij horen.
Het is dus deze verklaring van de ambtenaar die de nieuwe situatie tot stand brengt. Daarom beschouwen we die als primair: de verklaring ontstaat niet door afleiding, maar puur door het handelen van een daartoe bevoegde ambtenaar, die daarop ook aanspreekbaar is. De verklaring vormt bovendien de basis voor alles wat daarna met het huwelijk gebeurt.
Die vervolghandelingen gebeuren echter vaak niet op basis van de verklaring zelf, maar op basis van daarvan afgeleide representatie. Het echtpaar krijgt een papieren huwelijksakte thuisgestuurd, de bevolkingsregistratie verwerkt een gewijzigde burgerlijke staat en de Belastingdienst wil weten wie iemands fiscale partner is. Welke representatie nodig is, hangt dus af van de afnemer en diens informatiebehoefte.
Hoe komen performatieve handelingen en afgeleide representaties in het ontwerp terug? Binnen het register wordt expliciet onderscheid gemaakt tussen primaire en afgeleide beweringen.
Januskop als metafoor
De primaire verklaring en de daarvan afgeleide representaties hebben dus een heel verschillend karakter, maar zijn vanuit verantwoordingsperspectief allebei belangrijk. Een register staat daarmee op een overgang: tussen het handelen dat iets tot stand bracht en het handelen dat daarop volgt. De Romeinen hadden een god voor overgangen: Janus, die vaak wordt afgebeeld als een hoofd met twee gezichten. Het ene kijkt terug, het andere vooruit.
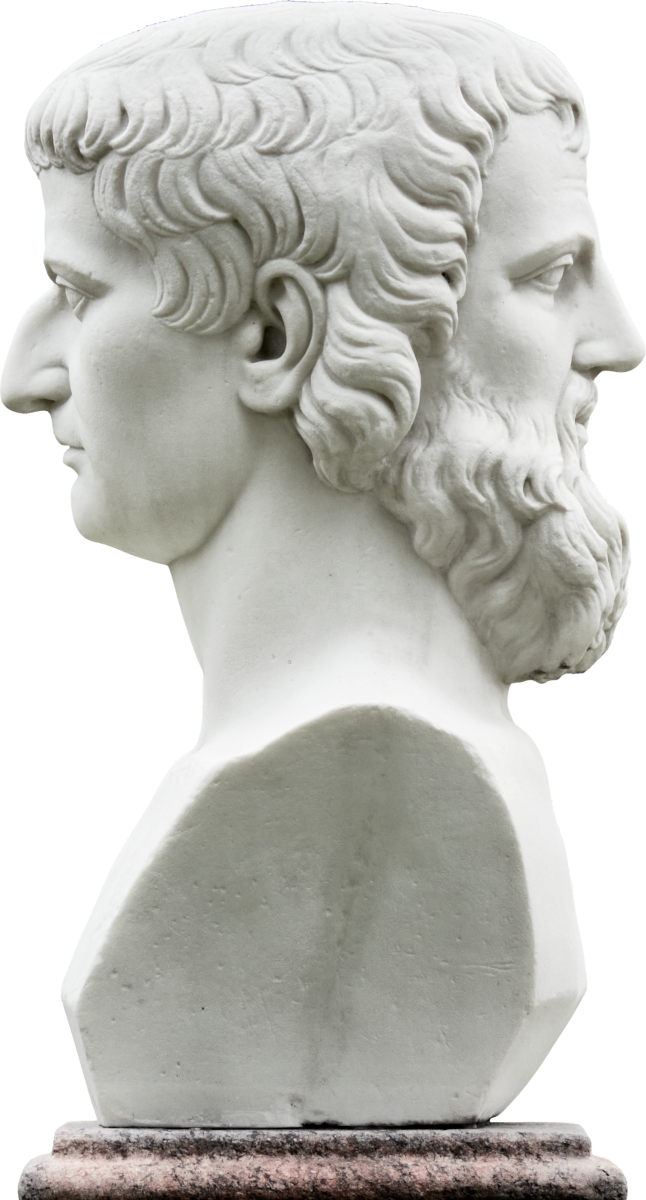
Januskop (afbeelding: Igor Gordeev)
Ook een register moet twee richtingen op kunnen kijken. Wie wil weten wat er gebeurd is, kijkt terug naar de verklaring en het handelen waaruit die ontstond. Wie wil begrijpen waarom andere partijen het huwelijk handelden zoals ze deden, kijkt vooruit naar de representaties waarop zij zich baseerden.
Janus heeft twee gezichten, maar één hoofd. Net zo horen primaire en afgeleide beweringen horen bij elkaar, in één register, dat ook vastlegt hoe de een uit de ander is afgeleid. Wijkt de akte af van de verklaring, of de burgerlijke staat van de akte, dan is na te gaan waar het misging.
Hoe komt de januskop in het ontwerp terug? Het register omvat voor beide perspectieven een eigen cluster: primaire beweringen worden in een journaal herkenbaar bijgehouden, terwijl de vorm van afgeleide beweringen wordt bepaald door op maat van afnemers gesneden projecties.
Bounded context als begrenzend begrip
Betekenis is belangrijk, maar zelden vanzelfsprekend: hetzelfde woord kan in verschillende situaties iets anders betekenen. Binnen de context die een register bedient, willen we daarom geen conflicterende betekenissen. Een domein in de gewone zin – "een sfeer van kennis, invloed of activiteit" – is daarvoor te ruim: binnen één domein kunnen dezelfde begrippen verschillend worden uitgelegd en kunnen regels elkaar tegenspreken.
Daarom bakenen we het werkingsgebied van registers af met een begrip uit Domain-driven design: de bounded context. Dat is een taakgebied dat in een gemeenschappelijke taal ondubbelzinnig en samenhangend is gemodelleerd. Binnen zo'n context worden begrippen eenduidig uitgelegd en sluiten regels en processen op elkaar aan.
Bounded contexten zijn zelden volledig onafhankelijk van elkaar. Informatie die in de ene context als resultaat van handelen werd geproduceerd, kan in een volgende context nodig zijn om nieuwe handelingen te initiëren. Waar informatie de grens tussen twee contexten oversteekt, ontstaat een contextovergang.
Hoe komt de bounded context in het ontwerp terug? Het bounded contextmodel maakt expliciet wat het register binnen zijn context kan beweren, en de vertaalregel helpt contextovergangen te expliciteren.
Waarover gaat dit ontwerp (niet)?
Betere ondersteuning van de crappy flow en epistemische nederigheid bij het gebruik van overheidsinformatie vragen om verandering op allerlei fronten: juridisch, organisatorisch en technisch. Samen vormen die een grote oplossingsruimte, waarvan dit ontwerp bewust maar een deel verkent. Om dat deel af te bakenen, gebruiken we twee architectuurmodellen die elkaar aanvullen: de European Interoperability Reference Architecture (EIRA) en het Common Ground-vijflagenmodel.
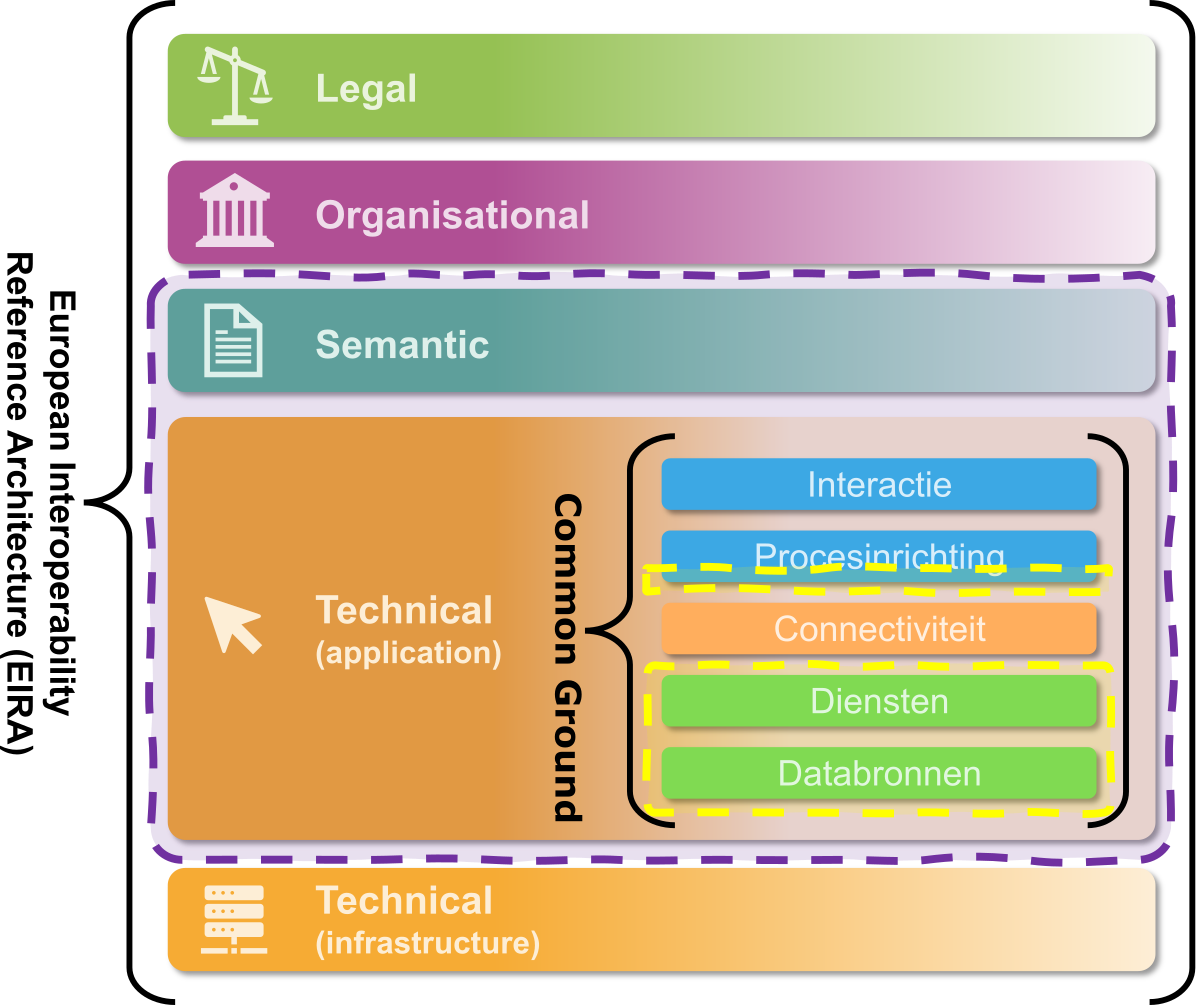
Binnen EIRA richten we ons op de semantische laag en de applicatielaag (de paarse gestreepte lijn in de figuur). Binnen de applicatielaag beperken we ons tot de Common Ground-lagen 'databronnen' en 'diensten', en – omdat processen de bijhoudingsdiensten gebruiken – een deel van 'procesinrichting' (de gele gestreepte lijn). We beschrijven dus de concepten, bouwblokken en generieke functionaliteit van een register, en hoe die met API's kan worden ontsloten.
Het ontwerp gaat niet over:
- de interpretatie of herziening van wet- en regelgeving;
- de verdeling van verantwoordelijkheden over organisaties, zoals gescheiden organisaties voor bijhouding en verstrekking, of een federatieve dan wel centrale inrichting;
- het gebruik van specifieke technische producten (al spelen die bij onze beproevingen wel een rol);
- het clusteren van applicatiecomponenten in één technisch product, en
- Interfaces die registergegevens aan gebruikers presenteren.
Wat betekent dit voor het registerbegrip?
Binnen de overheid lopen de opvattingen over wat een register is uiteen, van een volledig stelsel van wetgeving, organisaties en systemen tot een plek waar gegevens verkregen kunnen worden, tot simpelweg een database. Dit ontwerp beoogt niet deze interpretaties te verenigen of vervangen. Binnen dit ontwerp kiezen we echter wel één uitleg:
"Een register is applicatiefunctionaliteit die binnen een afgebakend domein primaire beweringen over overheidshandelen vastlegt en daarvan afgeleide beweringen verstrekt, zodanig dat hun herkomst, tijd, zekerheid en betekenis navolgbaar blijven en ze kunnen worden betwist en gecorrigeerd."
Elk onderdeel van deze definitie verwijst naar iets wat hierboven aan de orde kwam:
- applicatiefunctionaliteit – we beperken ons tot de semantische laag en de applicatielaag (zie Waarover gaat dit ontwerp (niet)?);
- afgebakend domein – een bounded context;
- primaire en afgeleide beweringen – het onderscheid tussen performatieve handelingen en afgeleide representaties, en de twee gezichten van de januskop;
- herkomst, tijd, zekerheid en betekenis – de betrouwbaarheidsaspecten die epistemische nederigheid mogelijk maken;
- betwisten en corrigeren – ondersteuning van de crappy flow.